tidyTuesday EP.2: เลิกแปลงข้อมูลนับด้วย \(\sqrt{y+0.5}\) แล้วมาใช้ Generalized Linear Mixed Models (GLMM) วิเคราะห์ข้อมูลจำนวนแมลงศัตรูพืชกันเถอะ

research
statistics
r
tidytuesday
entomology
glmm
เจาะลึกปัญหาของการแปลงข้อมูลนับจำนวนแมลงด้วยการถอดรากที่สอง (Square Root Transformation) และชี้ให้เห็นว่าทำไม Poisson และ Negative Binomial GLMM จึงเป็นวิธีที่ถูกต้องทางชีวสถิติ พร้อมอธิบาย Overdispersion, Jensen’s Inequality และตัวอย่างการแปลผลจริง
Published

3 พฤศจิกายน 2569

ใน tidyTuesday EP.2 นี้ เราจะมาสำรวจชุดข้อมูลคลาสสิกทางกีฏวิทยาและการเกษตร:

library(tidyverse)
library(agridat)
data("beall.webworms", package = "agridat")
dplyr::glimpse(beall.webworms)
Rows: 1,300
Columns: 7
$ row   <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 1…
$ col   <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1…
$ y     <int> 1, 0, 1, 3, 6, 0, 2, 2, 1, 3, 0, 3, 1, 0, 2, 0, 1, 4, 3, 3, 0, 0…
$ block <fct> B1, B1, B1, B1, B1, B2, B2, B2, B2, B2, B3, B3, B3, B3, B3, B4, …
$ trt   <fct> T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, T1, …
$ spray <fct> N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N…
$ lead  <fct> N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N, N…
ชุดข้อมูลนี้คือ beall.webworms บรรจุอยู่ในแพ็กเกจ agridat ซึ่งอ้างอิงจากการทดลองภาคสนามระดับคลาสสิกของ Geoffrey Beall (1940, Ecology, 21(4): 460–474) เรื่อง “The fit and significance of contagious distributions when applied to observations on larval insects”

การทดลองนี้มีเป้าหมายเพื่อทดสอบประสิทธิภาพของสารกำจัดแมลงศัตรูพืชในการควบคุม หนอนเจาะ/หนอนใยผักกาดหวาน (Beet webworm: Loxostege sticticalis L.) ในแปลงชูการ์บีต (Sugar beet) โดยวางแผนการทดลองแบบ Randomized Complete Block Design (RCBD) จำนวน 13 บล็อก (Blocks)

โครงสร้างทรีตเมนต์เป็นแบบ \(2 \times 2\) Factorial รวมทั้งสิ้น 4 ตำรับการทดลอง (Treatments):

  1. การพ่นสารกำจัดแมลงสัมผัสตาย (spray): 2 ระดับ คือ ไม่พ่นสาร (N: No Spray) และ พ่นสาร (Y: Contact Spray)
  2. การใช้เหยื่อพิษ/สารดูดซึมกระเพาะอาหาร (lead - Lead Arsenate): 2 ระดับ คือ ไม่ใช้เหยื่อ (N: No Lead) และ ใช้เหยื่อ (Y: Lead Arsenate)

ประกอบด้วย 4 ตำรับการทดลอง ได้แก่: * T1 (Control): ไม่พ่นสาร และ ไม่ใช้เหยื่อพิษ * T2 (Spray only): พ่นสารเคมีสัมผัสตายเพียงอย่างเดียว * T3 (Lead only): ใช้สารเหยื่อพิษตะกั่วอาร์ซีเนตเพียงอย่างเดียว * T4 (Spray + Lead): พ่นสารสัมผัสตายร่วมกับการใช้เหยื่อพิษ

ในแต่ละแปลงตำรับของแต่ละบล็อก จะแบ่งออกเป็น 25 แปลงย่อย (Unit areas) ขนาดแปลงละ 1 แถวยาว 3 ฟุต รวมทั้งสิ้น \(13 \text{ บล็อก} \times 4 \text{ ตำรับ} \times 25 \text{ จุดนับ} = \mathbf{1,300}\) จุดตรวจนับ (Observational units) โดยตัวแปรตาม (\(y\)) คือ จำนวนตัวหนอนที่นับได้จริงในแต่ละจุดตรวจนับ (\(y \in \{0, 1, 2, 3, \dots\}\) ตัว)

[บล็อกทดลองภาคสนาม: 13 Blocks (ความแปรปรวนของผืนดินและสภาพแวดล้อม)]
  │
  └── แปลงตำรับการทดลอง (4 Treatments: 2 x 2 Factorial)
        │  ├── T1: Control (ไม่พ่นสาร / ไม่ใช้เหยื่อ)
        │  ├── T2: Spray only (พ่นสารสัมผัสตาย)
        │  ├── T3: Lead only (ใช้เหยื่อพิษ)
        │  └── T4: Spray + Lead (พ่นสาร + ใช้เหยื่อพิษ)
        │
        └── จุดตรวจนับย่อย (25 Unit Areas ต่อแปลง รวม 1,300 แปลงย่อย)
              └── ตัวแปรตาม y: จำนวนหนอนที่นับได้ (0, 1, 2, 3, ... ตัว)

ข้อมูลที่เก็บเป็นประเภท ข้อมูลนับจำนวน (Count Data) เช่น จำนวนตัวหนอนที่พบบนต้นพืช, จำนวนแผลโรคไหม้ข้าวต่อใบ, จำนวนเพลี้ยกระโดดในกับดักแสงไฟ หรือจำนวนต้นวัชพืชต่อตารางเมตร

“ถ้าข้อมูลเป็นจำนวนนับ ให้เอาไปบวก 0.5 แล้วถอดรากที่สอง \(\sqrt{y + 0.5}\) หรือบวก 1 แล้วเทคล็อก \(\log(y + 1)\) เสียก่อน เพื่อให้ข้อมูลแจกแจงแบบปกติ แล้วค่อยนำไปรัน ANOVA ตามปกติ”

แต่ปัจจุบัน นักสถิติชีววิทยาชั้นนำทั่วโลกต่างออกมาบอกตรงกันว่า วิธีปฏิบัติเช่นนี้นำไปสู่การแปลผลที่ผิดเพี้ยนอย่างรุนแรง (Methodological Flaw) บทความวิชาการ Do not log-transform count data ของ O’Hara & Kotze (2010) ในวารสาร Methods in Ecology and Evolution และงานของ Stroup (2015) ใน Agronomy Journal ชี้ชัดว่า การแปลงข้อมูลที่ไม่ปกติให้เข้าหาโมเดลปกติ (normal distribution) เป็นวิธีคิดที่ล้าหลังและให้ผลลัพธ์ที่เอนเอียง

Noteธรรมชาติของข้อมูลทางกีฏวิทยาและโรคพืช (Contagious Distribution)

ตัวอ่อนของแมลงศัตรูพืชมักฟักออกมาจากกลุ่มไข่ที่แม่ผีเสื้อวางไว้เป็นกระจุก (Egg masses) ทำให้การกระจายตัวของตัวหนอนในแปลงมีลักษณะเป็นกลุ่มก้อน (Clumped หรือ Aggregated / Contagious Distribution) ในจุดที่แม่แมลงวางไข่จะมีหนอนอัดแน่นหลายตัว ขณะที่พื้นที่รอบข้างส่วนใหญ่จะมีค่าเป็นศูนย์ (Zero-inflated / Right-skewed) ธรรมชาติเช่นนี้ทำให้ข้อมูลฉีกหนีออกจากระฆังคว่ำ (Normal Distribution) ไปอย่างสิ้นเชิง

ในบทความนี้ เราจะมาเจาะลึกชุดข้อมูลของ Geoffrey Beall (1940) เพื่อพิสูจน์ให้เห็นว่าทำไมการแปลงข้อมูลด้วย \(\sqrt{y+0.5}\) จึงประเมินการระบาดของแมลงต่ำกว่าความเป็นจริง และทำไม Generalized Linear Mixed Models (GLMM) จึงเป็นคำตอบที่ถูกต้องและน่าเชื่อถือที่สุด


2. ทำไมถึงต้องวิเคราะห์ด้วย GLMM แทนการแปลงข้อมูลแบบเดิม? (Why This Statistical Approach?)

Note

การตรวจนับจำนวนแมลง แผลโรคพืช หรือวัชพืช ข้อมูลมักจะเบ้ขวา มีศูนย์เป็นจำนวนมาก และที่สำคัญที่สุดคือ ความแปรปรวนจะเพิ่มขึ้นตามค่าเฉลี่ย (Mean-Variance Relationship)

ตามตำราสถิติเดิม มักแนะนำให้ใช้การแปลงข้อมูลแบบถอดรากที่สอง (Square Root Transformation) ด้วยสูตรของ Bartlett (1936) หรือ Freeman-Tukey (1950):

\[z = \sqrt{y + 0.5}\]

แล้วนำค่า \(z\) ไปรันการวิเคราะห์ความแปรปรวน (ANOVA) ตามปกติ แต่วิธีการนี้มี จุดอ่อนและอันตรายแฝง 3 ประการ ที่ไม่ควรนำมาใช้ในงานวิจัย:

2.1 อสมการของเจนเซนและความเอนเอียงจากการแปลงย้อนกลับ (Jensen’s Inequality & Back-Transformation Bias)

จุดเสียทางคณิตศาสตร์ที่ร้ายแรงที่สุด: ค่าเฉลี่ยของข้อมูลที่แปลงแล้ว เมื่อแปลงย้อนกลับ จะไม่เท่ากับค่าเฉลี่ยของข้อมูลจริงบนโลกธรรมชาติ!

ตามหลักคณิตศาสตร์ อสมการของเจนเซน (Jensen’s Inequality) ระบุว่า สำหรับฟังก์ชันที่มีความเว้า (Concave Function) เช่น ฟังก์ชันรากที่สอง \(g(y) = \sqrt{y + c}\):

\[\text{E}[\sqrt{Y + c}] < \sqrt{\text{E}[Y] + c}\]

เมื่อคำนวณค่าเฉลี่ยในสเกลที่แปลงแล้ว \(\bar{z}\) แล้วพยายามแปลงกลับ (Back-transform) สู่จำนวนแมลงด้วยการยกกำลังสอง:

\[\hat{\mu}_{\text{back}} = (\bar{z})^2 - 0.5\]

ค่าที่ได้จะ ต่ำกว่าค่าเฉลี่ยของจำนวนแมลงจริงเสมอ (\(\hat{\mu}_{\text{back}} < \bar{y}\))!

  • ในกลุ่มควบคุม (Control: T1) ค่าเฉลี่ยแมลงที่นับได้จริงในแปลงคือ \(1.40\) ตัว/แปลง (และโมเดล GLMM ประมาณการค่าเฉลี่ยประชากรไว้ที่ \(1.33\) ตัว/แปลง)
  • ทว่าหากนำข้อมูลไปแปลงเป็น \(\sqrt{y + 0.5}\) ค่าเฉลี่ยที่ได้บนสเกลแปลงคือ \(1.27\) เมื่อยกกำลังสองลบออกด้วย 0.5 จะได้ค่าเฉลี่ยเพียง \(1.12\) ตัว/แปลง
  • นั่นหมายความว่า การแปลงข้อมูลทำให้เราประเมินจำนวนแมลงศัตรูพืชต่ำกว่าความเป็นจริงไปถึง 16–20%!
Cautionผลกระทบเชิงเศรษฐกิจของการแปลงข้อมูล

ในการจัดการศัตรูพืชแบบผสมผสาน (IPM) เราต้องใช้จำนวนแมลงในการตัดสินใจพ่นสารเคมีตาม ระดับเศรษฐกิจ (Economic Injury Level: EIL) หากการคำนวณทางสถิติประเมินประชากรแมลงต่ำกว่าจริงไป 16–20% เกษตรกรอาจประเมินความเสี่ยงต่ำไป ไม่พ่นสารเคมีควบคุมในจังหวะที่เหมาะสม และทำให้ผลผลิตเสียหายอย่างประเมินค่าไม่ได้


2.2 ปัญหา Overdispersion และการกระจายตัวแบบรวมกลุ่ม (Clumped Aggregation)

แบบจำลองถดถอยเชิงเส้น Linear Model รวมถึง ANOVA มีข้อกำหนดเบื้องต้นว่า ความแปรปรวนของทุกกลุ่มการทดลองต้องเท่ากัน (Homoscedasticity) และจะใช้ค่าความคลาดเคลื่อนรวมเพียงค่าเดียว (Pooled Residual Variance: \(\sigma^2\)) ในการคำนวณ Standard Error ให้กับทุกกลุ่ม

แต่ในแปลงทดลองแมลงศัตรูพืช ความแปรปรวนขึ้นตรงกับความหนาแน่นของแมลง: * แปลงที่แมลงระบาดหนัก (Control: T1) มีความแปรปรวนสูงถึง \(s^2 = 2.33\) * แปลงที่ควบคุมแมลงได้ดีที่สุด (Spray + Lead: T4) มีความแปรปรวนเหลือเพียง \(s^2 = 0.52\)

การบีบให้ทุกกลุ่มใช้ Pooled Error เดียวกัน ทำให้ช่วงความเชื่อมั่นของกลุ่มควบคุมแคบเกินจริง และทำให้ช่วงความเชื่อมั่นของกลุ่มจัดการกว้างเกินจริง

นอกจากนี้ การใช้ Poisson Distribution ซึ่งมีข้อกำหนดเข้มงวดว่า ความแปรปรวนต้องเท่ากับค่าเฉลี่ย (\(\text{Var}(Y) = \mu\)) ก็มักจะไม่ผ่านในแปลงเกษตร เพราะแมลงอยู่เป็นกลุ่มก้อน ก่อให้เกิดภาวะ Overdispersion (\(\text{Var}(Y) > \mu\))

แบบจำลองที่เหมาะสมที่สุดจึงเป็น Negative Binomial GLMM (แบบจำลองทวินามเชิงลบ) ซึ่งยอมให้ความแปรปรวนเพิ่มขึ้นตามค่าเฉลี่ยในรูปกำลังสอง:

\[\text{Var}(Y) = \mu + \frac{\mu^2}{\theta}\]

โดยที่ \(\theta\) คือพารามิเตอร์การกระจายตัว (Dispersion Parameter) ยิ่งแมลงเกาะกลุ่มกันมาก ค่า \(\theta\) จะยิ่งต่ำ


2.3 การแปลผลปฏิกิริยาร่วม (Interaction) และอัตราส่วนอุบัติการณ์ (Incidence Rate Ratio: IRR)

เมื่อรัน 2-way ANOVA บนข้อมูลที่แปลงด้วย \(\sqrt{y+0.5}\) ผลของปฏิกิริยาร่วม (Interaction: spray:lead) จะเป็นการทดสอบว่า:

\[\sqrt{\mu_{11}} - \sqrt{\mu_{10}} \stackrel{?}{=} \sqrt{\mu_{01}} - \sqrt{\mu_{00}}\]

คำถามคือ “ผลต่างของรากที่สองของจำนวนแมลง” มีความหมายทางชีววิทยาอย่างไร? คำตอบคือไม่มีนักกีฏวิทยาคนใดในโลกสามารถอธิบายผลต่างของรากที่สองให้เกษตรกรเข้าใจได้!

ในทางตรงกันข้าม หากเราใช้ GLMM ร่วมกับ ฟังก์ชันเชื่อมโยงลอการิทึม (Log Link: \(\log(\mu)\)):

\[\log(\mu) = \beta_0 + \beta_1(\text{spray}) + \beta_2(\text{lead}) + \beta_3(\text{spray} \times \text{lead}) + b_{\text{block}}\]

เมื่อเราแปลงกลับด้วยฟังก์ชันเอ็กซ์โพเนนเชียล (\(\exp\)):

\[\mu = \exp(\beta_0) \times \exp(\beta_1)^{\text{spray}} \times \exp(\beta_2)^{\text{lead}} \times \exp(\beta_3)^{\text{spray}\times\text{lead}}\]

ค่า \(\exp(\beta)\) จะกลายเป็น Incidence Rate Ratio (IRR) หรืออัตราส่วนการเปลี่ยนแปลงของประชากรแมลงทันที: * ถ้า \(\text{IRR} = 0.364\) แปลว่าการพ่นสารช่วยลดจำนวนแมลงลงเหลือ \(36.4\%\) ของกลุ่มควบคุม หรือ มีประสิทธิภาพในการควบคุมแมลง \((1 - 0.364) \times 100\% = 63.6\%\) * หากเทอม Interaction (\(\beta_3\)) ไม่มีนัยสำคัญทางสถิติ (\(p > 0.05\)) แสดงว่ากลไกการออกฤทธิ์ของสารทั้งสองเป็น อิสระต่อกันในเชิงคูณ (Bliss Independence / Independent Multiplicative Action) เมื่อนำมาใช้ร่วมกัน ประสิทธิภาพจะคูณเสริมกันโดยตรง ซึ่งแปลผลทางชีววิทยาได้อย่างชัดเจน


3. โค้ด R สำหรับการวิเคราะห์ (R Code Workflow)

กระบวนการวิเคราะห์ข้อมูลเริ่มตั้งแต่การตรวจสอบความสัมพันธ์ Mean-Variance, การรันโมเดล ANOVA ยุคดั้งเดิมเพื่อเทียบ Bias, การฟิตแบบจำลอง Poisson เทียบกับ Negative Binomial GLMM ผ่านแพ็กเกจ glmmTMB, การตรวจสอบ Residuals ด้วย DHARMa ไปจนถึงการสกัดค่าเฉลี่ยคาดหมายบน Response Scale ด้วย emmeans และการพล็อตภาพด้วย ggplot2:

3.1 โหลดแพ็กเกจที่จำเป็น (Load Packages)

library(agridat) # คลังข้อมูลสถิติเกษตรคลาสสิก (Beall 1940)
library(tidyverse) # ชุดเครื่องมือจัดการข้อมูลและกราฟิก (dplyr, ggplot2)
library(glmmTMB) # รัน Generalized Linear Mixed Models ประสิทธิภาพสูง
library(DHARMa) # วินิจฉัย Residuals ของ GLMM ด้วย Simulation
library(emmeans) # สกัดค่าเฉลี่ยคาดหมายบนสเกลจริง (Response scale)

3.2 จัดการและทำความสะอาดข้อมูล (Data Cleaning & Preparation)

data("beall.webworms", package = "agridat")

worm_df <- beall.webworms |>
  mutate(
    block = factor(block),
    spray = factor(
      spray,
      levels = c("N", "Y"),
      labels = c("ไม่พ่นสาร (No Spray)", "พ่นสาร (Spray)")
    ),
    lead = factor(
      lead,
      levels = c("N", "Y"),
      labels = c("ไม่ใช้เหยื่อ (No Lead)", "ใช้เหยื่อ (Lead)")
    ),
    trt_label = factor(
      trt,
      levels = c("T1", "T2", "T3", "T4"),
      labels = c(
        "T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)",
        "T2: พ่นสารอย่างเดียว",
        "T3: ใช้เหยื่ออย่างเดียว",
        "T4: พ่นสาร + ใช้เหยื่อ"
      )
    )
  )

worm_df |> head()
  row col y block trt              spray               lead
1   1   1 1    B1  T1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead)
2   2   1 0    B1  T1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead)
3   3   1 1    B1  T1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead)
4   4   1 3    B1  T1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead)
5   5   1 6    B1  T1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead)
6   6   1 0    B2  T1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead)
                    trt_label
1 T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)
2 T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)
3 T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)
4 T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)
5 T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)
6 T1: Control (ไม่พ่น/ไม่ใช้เหยื่อ)

3.3 สำรวจความสัมพันธ์ระหว่างค่าเฉลี่ยและความแปรปรวน (Mean-Variance Check)

worm_summary <- worm_df |>
  group_by(trt_label, spray, lead) |>
  summarise(
    n_plots = n(),
    mean_count = mean(y),
    var_count = var(y),
    dispersion_ratio = var_count / mean_count, # ถ้า > 1 บ่งชี้ภาวะ Overdispersion
    pct_zeros = mean(y == 0) * 100,
    .groups = "drop"
  )

worm_summary
# A tibble: 4 × 8
  trt_label  spray lead  n_plots mean_count var_count dispersion_ratio pct_zeros
  <fct>      <fct> <fct>   <int>      <dbl>     <dbl>            <dbl>     <dbl>
1 T1: Contr… ไม่พ่น… ไม่ใช้…     325      1.4       2.33              1.66      36  
2 T2: พ่นสาร… พ่นสา… ไม่ใช้…     325      0.505     0.584             1.16      63.1
3 T3: ใช้เหยื่… ไม่พ่น… ใช้เห…     325      0.852     1.14              1.34      49.8
4 T4: พ่นสาร… พ่นสา… ใช้เห…     325      0.412     0.521             1.26      69.8

จากตารางสรุปด้านบน จะเห็นได้ชัดเจนว่า: 1. ค่าความแปรปรวน (var_count) ไม่คงที่ โดยแปรผันตามค่าเฉลี่ย (mean_count) ตั้งแต่ \(0.52\) ในแปลง T4 ไปจนถึง \(2.33\) ในแปลงควบคุม T1 2. อัตราส่วนความแปรปรวนต่อค่าเฉลี่ย (dispersion_ratio) มีค่ามากกว่า \(1\) ในทุกกลุ่ม (\(1.16 - 1.66\)) บ่งชี้ว่าข้อมูลมีความแปรปรวนเกิน (Overdispersion) เกินกว่าที่การแจกแจงแบบ Poisson จะรับไหว


3.4 เปรียบเทียบกับวิธีดั้งเดิม: การแปลงข้อมูลด้วย \(\sqrt{y + 0.5}\) แล้วรัน ANOVA

3.4.1 ANOVA บนข้อมูลที่แปลงด้วยรากที่สอง

แปลงตัวแปรตาม \(y\) ด้วยการถอดรากที่สอง \(\sqrt{y + 0.5}\) แล้วรัน ANOVA ตามแบบแผน RCBD โดยกำหนดให้ block เป็น Random Error Term:

mod_trans <- aov(sqrt(y + 0.5) ~ spray * lead + Error(block), data = worm_df)
summary(mod_trans)

Error: block
          Df Sum Sq Mean Sq F value Pr(>F)
Residuals 12  13.62   1.135               

Error: Within
             Df Sum Sq Mean Sq F value   Pr(>F)    
spray         1  21.21  21.215  133.35  < 2e-16 ***
lead          1   4.50   4.496   28.26 1.25e-07 ***
spray:lead    1   1.78   1.776   11.16 0.000858 ***
Residuals  1284 204.27   0.159                     
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

ข้อสังเกต: ในผลลัพธ์ ANOVA ข้างต้น ปฏิกิริยาร่วม spray:lead มีนัยสำคัญทางสถิติอย่างยิ่งยวด (\(F = 11.16, p = 0.000858\)) ซึ่งชวนให้สรุปว่าสารเคมีสัมผัสตายและเหยื่อพิษมีผลขัดขวางหรือเสริมฤทธิ์กัน แต่เราจะมาดูกันว่าผล Interaction นี้เป็นเพียงภาพลวงตาจากการบิดเบือนสเกลหรือไม่

3.4.2 การฟิต Poisson GLMM เทียบกับ Negative Binomial GLMM

  • กำหนด Fixed Effects: spray * lead
  • กำหนด Random Effect: (1 | block) เพื่อควบคุมความแปรปรวนเชิงพื้นที่ระหว่างบล็อกทดลอง
mod_pois <- glmmTMB(
  y ~ spray * lead + (1 | block),
  family = poisson(link = "log"),
  data = worm_df
)

mod_nbin <- glmmTMB(
  y ~ spray * lead + (1 | block),
  family = nbinom2(link = "log"),
  data = worm_df
)

# เปรียบเทียบความเหมาะสมของโมเดลด้วยค่า AIC
AIC(mod_pois, mod_nbin)
         df      AIC
mod_pois  5 3047.988
mod_nbin  6 3007.412

ค่า AIC ของ Negative Binomial GLMM ต่ำกว่า Poisson GLMM ถึง \(40.58\) หน่วย (\(\Delta\text{AIC} = 40.58 > 10\)) ชี้ชัดว่าแบบจำลองทวินามเชิงลบมีความเหมาะสมและใกล้เคียงข้อมูลจริงมากกว่าอย่างเด็ดขาด

Tipเกณฑ์การอ่านผลต่างของ AIC (\(\Delta\text{AIC}\))

เมื่อคำนวณ \(\Delta\text{AIC} = \text{AIC}_{\text{model}} - \text{AIC}_{\text{min}}\):

  • \(\Delta\text{AIC} \le 2\): สองโมเดลแทบไม่ต่างกัน ให้เลือกโมเดลที่เรียบง่ายกว่า (Parsimonious)
  • \(\Delta\text{AIC} = 4 - 7\): โมเดลที่มีค่า AIC สูงกว่า เริ่มมีหลักฐานสนับสนุนน้อยลงอย่างเห็นได้ชัด
  • \(\Delta\text{AIC} > 10\): โมเดลที่มีค่า AIC สูงกว่า แทบไม่มีความน่าเชื่อถือทางสถิติเหลืออยู่เลย (ตัดทิ้งได้ทันที)

3.5 วินิจฉัยแบบจำลองด้วยแพ็กเกจ DHARMa

ในการใช้ GLMM เราต้องตรวจสอบสมมติฐานทางสถิติ (Assumption Checking) ผ่านการจำลอง Simulated Residuals ด้วยแพ็กเกจ DHARMa:

3.5.1 การวินิจฉัย Poisson GLMM

sim_res_pois <- simulateResiduals(mod_pois)
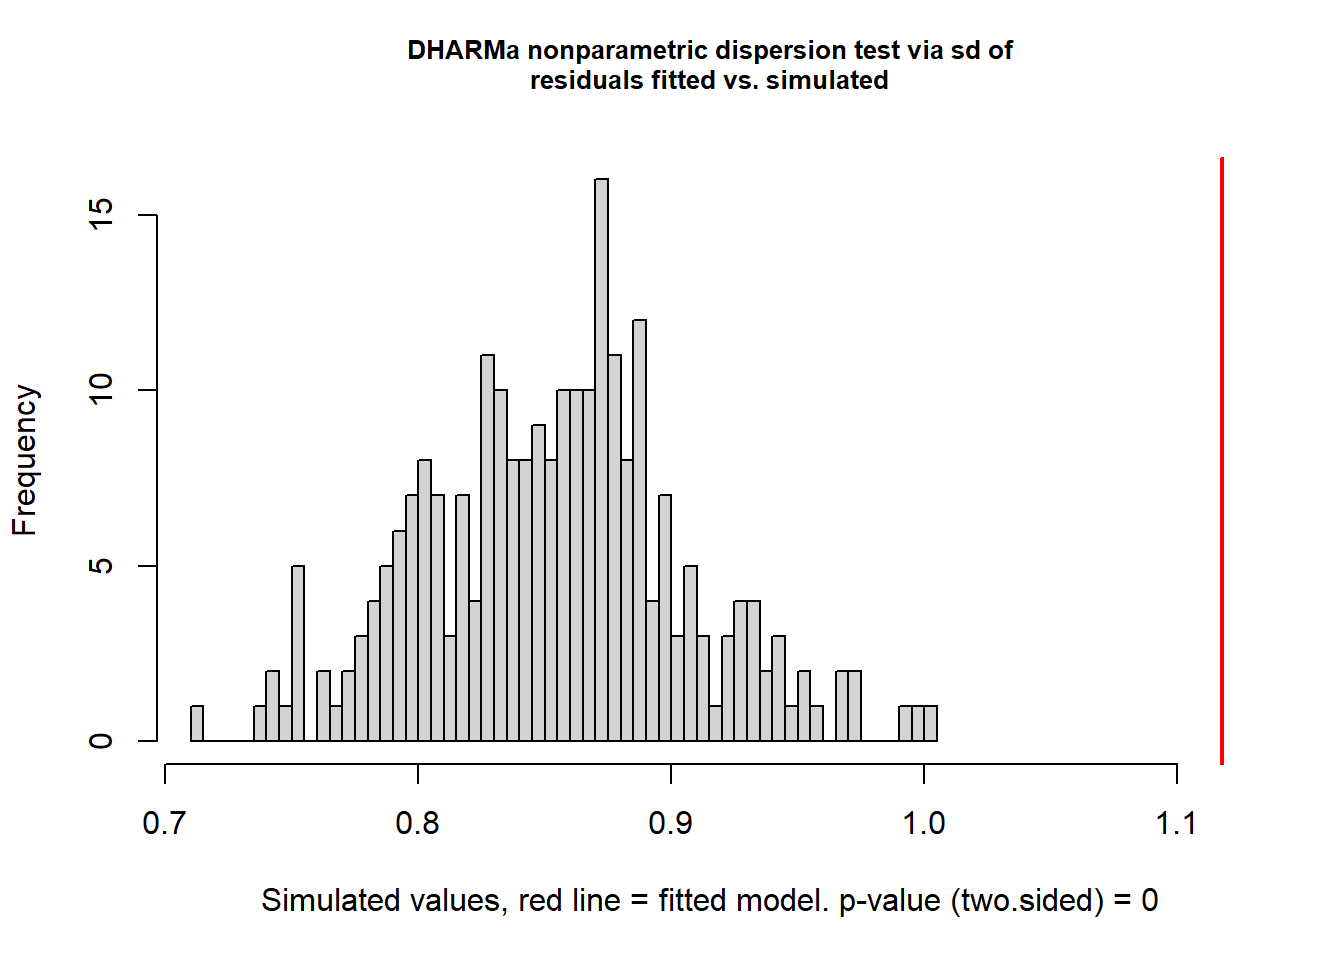
testDispersion(sim_res_pois)


    DHARMa nonparametric dispersion test via sd of residuals fitted vs.
    simulated

data:  simulationOutput
dispersion = 1.3094, p-value < 2.2e-16
alternative hypothesis: two.sided
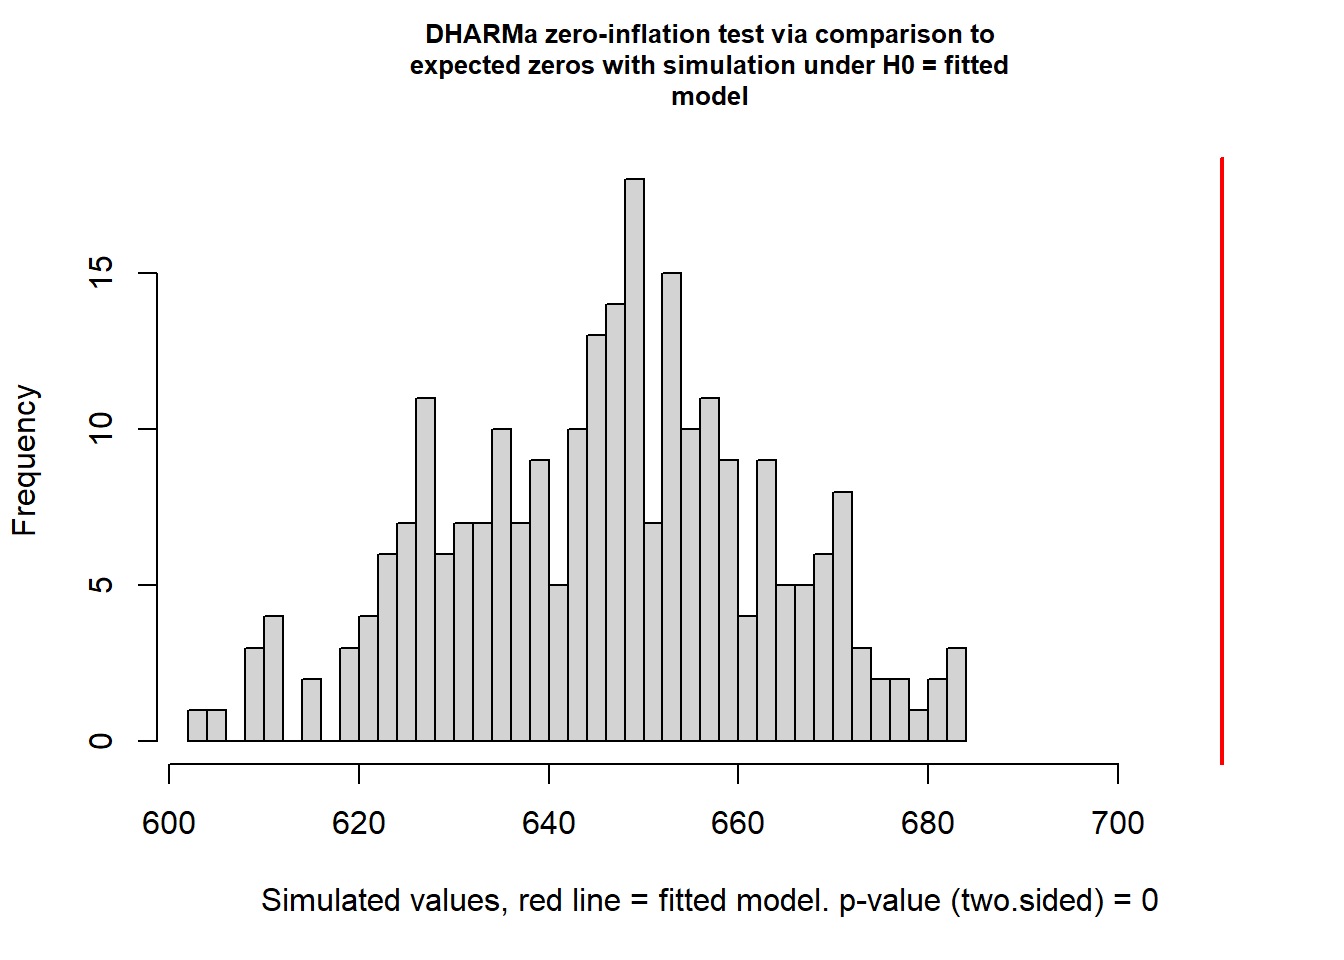
testZeroInflation(sim_res_pois)


    DHARMa zero-inflation test via comparison to expected zeros with
    simulation under H0 = fitted model

data:  simulationOutput
ratioObsSim = 1.0996, p-value < 2.2e-16
alternative hypothesis: two.sided

ผลการทดสอบแสดง Overdispersion รุนแรงใน Poisson (\(p < 2.2 \times 10^{-16}\)) และพบปัญหา Zero-inflation เทียมที่เกิดจากโมเดลไม่สามารถรองรับการแปรปรวนที่กว้างพอ

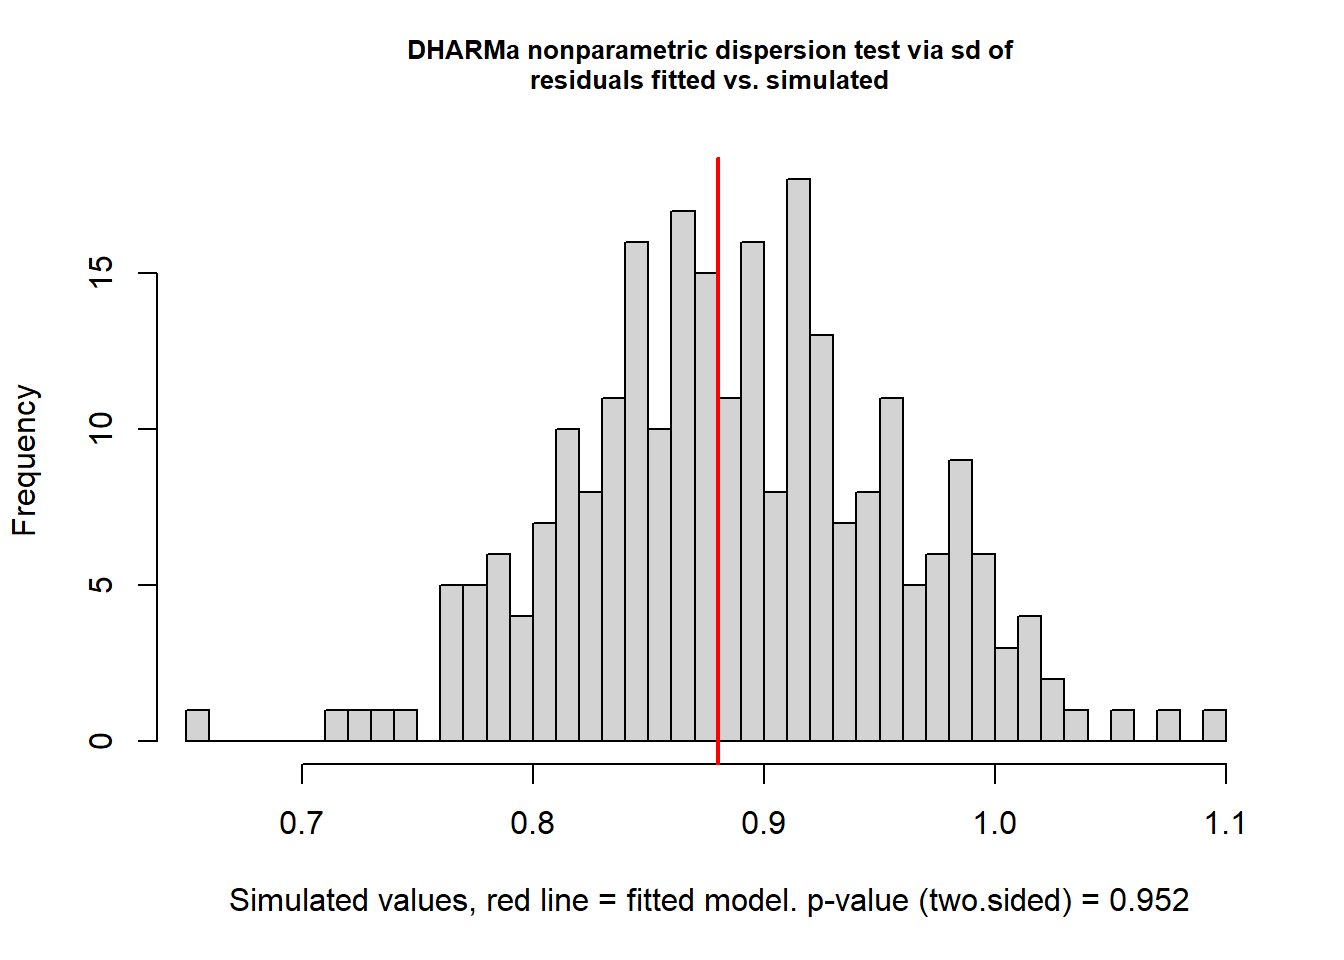
3.5.2 การวินิจฉัย Negative Binomial GLMM

sim_res_nbin <- simulateResiduals(mod_nbin)
testDispersion(sim_res_nbin)


    DHARMa nonparametric dispersion test via sd of residuals fitted vs.
    simulated

data:  simulationOutput
dispersion = 0.99163, p-value = 0.952
alternative hypothesis: two.sided
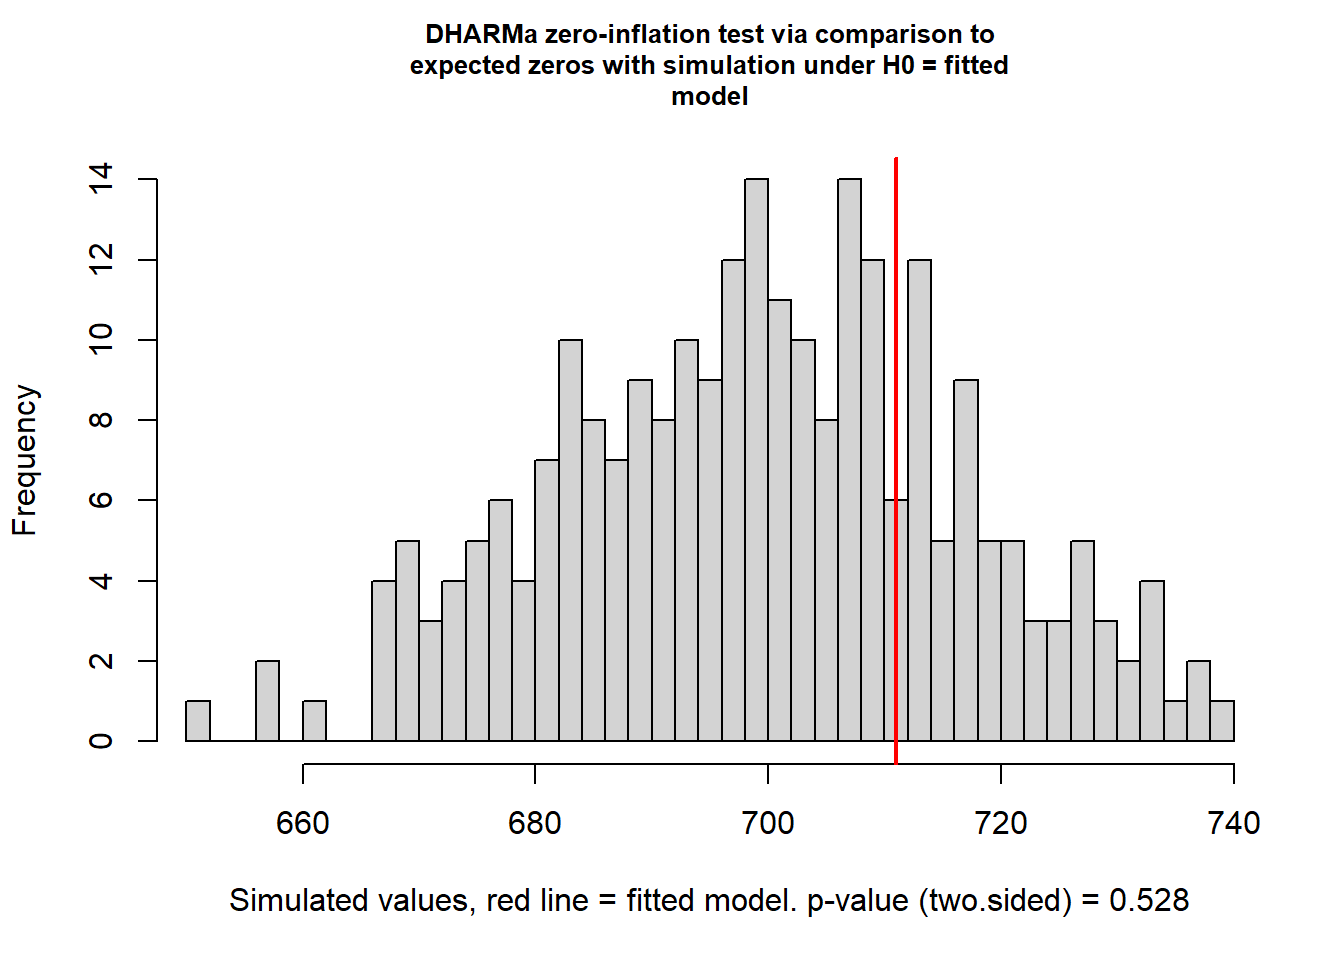
testZeroInflation(sim_res_nbin)


    DHARMa zero-inflation test via comparison to expected zeros with
    simulation under H0 = fitted model

data:  simulationOutput
ratioObsSim = 1.0162, p-value = 0.528
alternative hypothesis: two.sided

ผลการวินิจฉัยของ Negative Binomial: * การทดสอบ Dispersion ผ่านฉลุย (\(p = 0.952 > 0.05\)) ไม่พบ Overdispersion หลงเหลือ * การทดสอบ Zero-Inflation ผ่านฉลุย (\(p = 0.528 > 0.05\)) สัดส่วนของศูนย์ในข้อมูลสังเกตจริงตรงกับที่โมเดลคาดการณ์ไว้โดยสมบูรณ์ ไม่จำเป็นต้องใช้โมเดล Zero-Inflated เพิ่มเติม

เราจึงเลือก mod_nbin มาใช้เป็นโมเดลหลักในการวิเคราะห์และสรุปผล


3.6 สกัดค่าเฉลี่ยคาดหมายบนสเกลจำนวนแมลงจริง (Response Scale: Back-transformed)

ในโมเดล Negative Binomial GLMM เราไม่ได้นำจำนวนแมลง (\(y\)) ไปใส่ \(\log\) ตรง ๆ แต่โมเดลใช้ฟังก์ชันเชื่อมโยง (Log link function) กับค่าเฉลี่ยคาดหมาย (\(\mu\)):

\[\log(\mu) = \beta_0 + \beta_1(\text{spray}) + \beta_2(\text{lead}) + \beta_3(\text{spray} \times \text{lead})\]

  • บน Link scale (สเกลลอการิทึม): ค่าพารามิเตอร์ที่ได้จะอยู่ในรูปสัมประสิทธิ์ \(\beta\) ซึ่งไม่มีความหมายเชิงกายภาพที่เกษตรกรจะเข้าใจได้โดยตรง
  • บน Response scale (สเกลจำนวนตัวจริง): เราจะแปลงกลับด้วยฟังก์ชันผกผัน (Inverse-link) นั่นคือ \(\hat{\mu} = \exp(\hat{\eta})\) เพื่อให้ได้ค่าเฉลี่ยประชากรในหน่วย “จำนวนหนอน/แปลง” สำหรับใช้ประเมินระดับเศรษฐกิจได้ทันที

เราใช้คำสั่ง emmeans พร้อมระบุ type = "response" เพื่อสกัดค่าเฉลี่ยคาดหมายและช่วงความเชื่อมั่น 95%:

emm_res <- emmeans(mod_nbin, ~ spray * lead, type = "response")
summary(emm_res)
 spray                  lead                       response     SE  df
   ไม่พ่นสาร (No Spray)       ไม่ใช้เหยื่อ (No Lead)        1.328 0.1440 Inf
   พ่นสาร (Spray)            ไม่ใช้เหยื่อ (No Lead)        0.483 0.0603 Inf
   ไม่พ่นสาร (No Spray)       ใช้เหยื่อ (Lead)             0.805 0.0923 Inf
   พ่นสาร (Spray)            ใช้เหยื่อ (Lead)             0.392 0.0511 Inf
 asymp.LCL asymp.UCL
     1.074     1.641
     0.378     0.617
     0.643     1.008
     0.303     0.506

Confidence level used: 0.95 
Intervals are back-transformed from the log scale 
# คำนวณอัตราส่วนการลดลงของแมลง (Incidence Rate Ratio: IRR) และประสิทธิผล (%)
contrast_res <- contrast(emm_res, method = "revpairwise", by = "lead")
summary(contrast_res, type = "response")
lead = ไม่ใช้เหยื่อ (No Lead):
 contrast                                 ratio     SE  df null z.ratio p.value
    พ่นสาร (Spray) / ไม่พ่นสาร (No Spray)    0.364 0.0376 Inf    1  -9.792 <0.0001

lead = ใช้เหยื่อ (Lead):
 contrast                                 ratio     SE  df null z.ratio p.value
    พ่นสาร (Spray) / ไม่พ่นสาร (No Spray)    0.487 0.0565 Inf    1  -6.209 <0.0001

Tests are performed on the log scale 
# แปลงผลลัพธ์เพื่อนำไปสร้างกราฟ
emm_df <- as.data.frame(emm_res)
emm_df
 spray                  lead                        response         SE  df
   ไม่พ่นสาร (No Spray)       ไม่ใช้เหยื่อ (No Lead)     1.3277277 0.14356488 Inf
   พ่นสาร (Spray)            ไม่ใช้เหยื่อ (No Lead)     0.4827957 0.06034845 Inf
   ไม่พ่นสาร (No Spray)       ใช้เหยื่อ (Lead)          0.8049737 0.09228395 Inf
   พ่นสาร (Spray)            ใช้เหยื่อ (Lead)          0.3917425 0.05109299 Inf
 asymp.LCL asymp.UCL
 1.0741627 1.6411488
 0.3778897 0.6168248
 0.6429809 1.0077790
 0.3033771 0.5058463

Confidence level used: 0.95 
Intervals are back-transformed from the log scale 

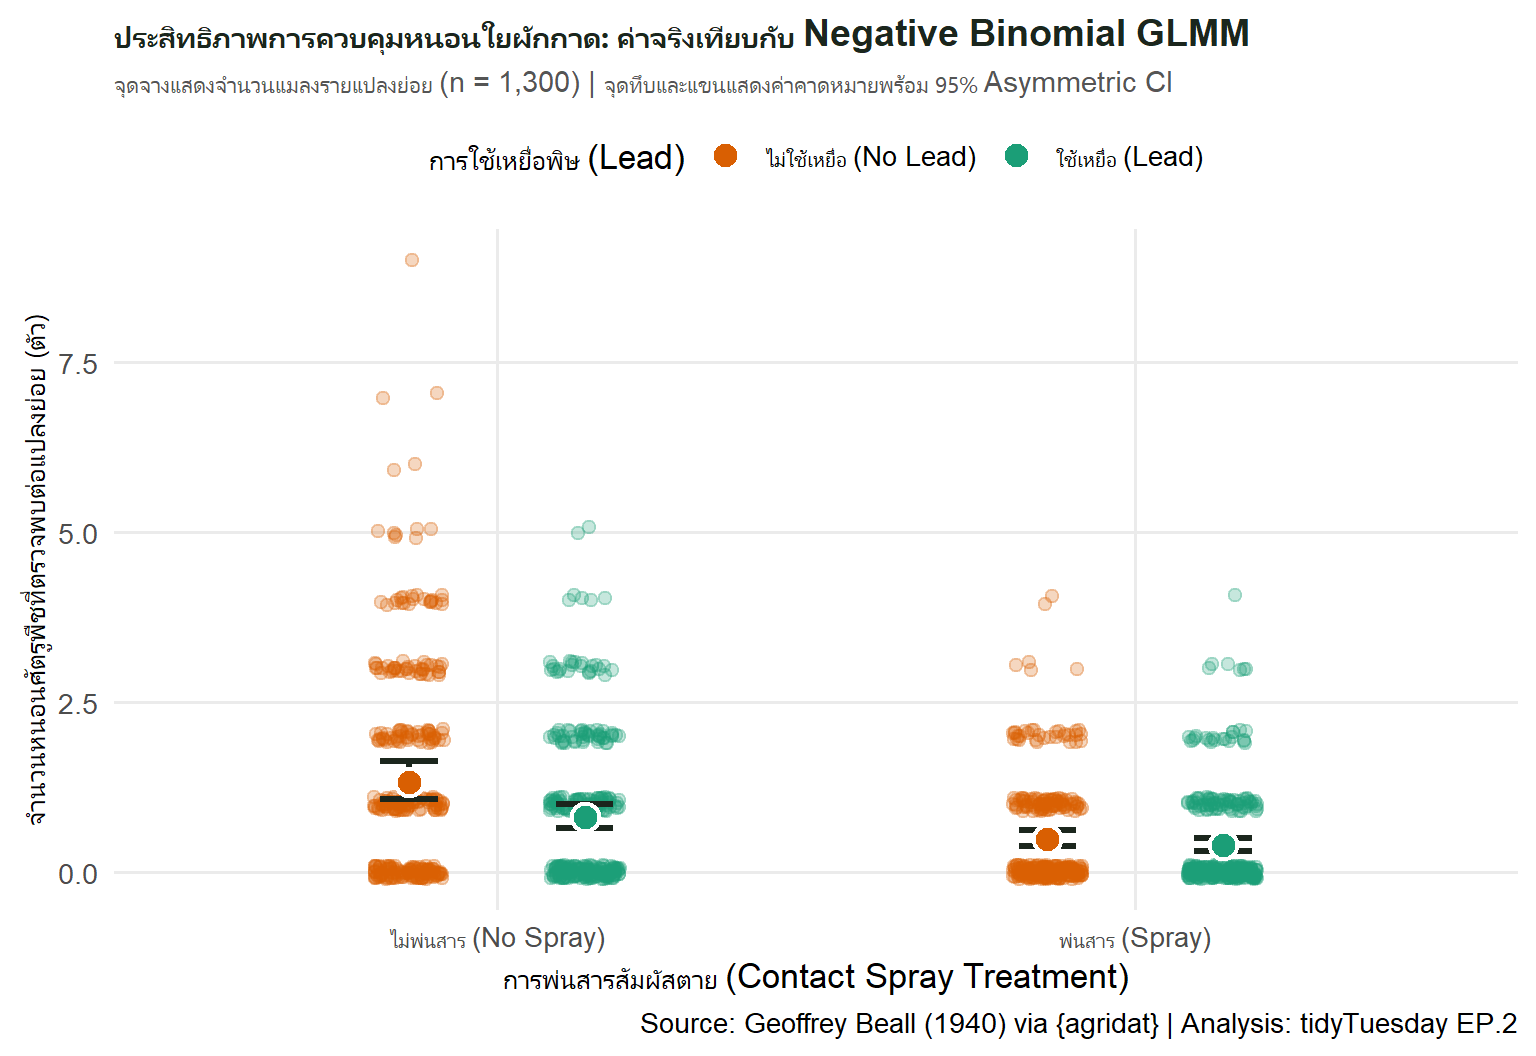
3.7 สร้างกราฟนำเสนอสไตล์ TidyTuesday

ggplot() +
  geom_jitter(
    data = worm_df,
    aes(x = spray, y = y, color = lead),
    position = position_jitterdodge(
      jitter.width = 0.22,
      jitter.height = 0.1,
      dodge.width = 0.55
    ),
    alpha = 0.25,
    size = 2
  ) +
  geom_errorbar(
    data = emm_df,
    aes(x = spray, ymin = asymp.LCL, ymax = asymp.UCL, group = lead),
    position = position_dodge(width = 0.55),
    width = 0.18,
    linewidth = 1.1,
    color = "#1B261D"
  ) +
  geom_point(
    data = emm_df,
    aes(x = spray, y = response, fill = lead),
    position = position_dodge(width = 0.55),
    size = 4.2,
    shape = 21,
    color = "#FFFFFF",
    stroke = 1.3
  ) +
  scale_color_manual(
    values = c("ไม่ใช้เหยื่อ (No Lead)" = "#D95F02", "ใช้เหยื่อ (Lead)" = "#1B9E77"),
    name = "การใช้เหยื่อพิษ (Lead)"
  ) +
  scale_fill_manual(
    values = c("ไม่ใช้เหยื่อ (No Lead)" = "#D95F02", "ใช้เหยื่อ (Lead)" = "#1B9E77"),
    name = "การใช้เหยื่อพิษ (Lead)"
  ) +
  labs(
    title = "ประสิทธิภาพการควบคุมหนอนใยผักกาด: ค่าจริงเทียบกับ Negative Binomial GLMM",
    subtitle = "จุดจางแสดงจำนวนแมลงรายแปลงย่อย (n = 1,300) | จุดทึบและแขนแสดงค่าคาดหมายพร้อม 95% Asymmetric CI",
    x = "การพ่นสารสัมผัสตาย (Contact Spray Treatment)",
    y = "จำนวนหนอนศัตรูพืชที่ตรวจพบต่อแปลงย่อย (ตัว)",
    caption = "Source: Geoffrey Beall (1940) via {agridat} | Analysis: tidyTuesday EP.2"
  ) +
  theme_minimal(base_size = 13) +
  theme(
    legend.position = "top",
    plot.title = element_text(face = "bold", size = 14, color = "#1B261D"),
    plot.subtitle = element_text(size = 11, color = "#555555"),
    panel.grid.minor = element_blank(),
    strip.background = element_rect(fill = "#FAF9F4", color = "#DDDCD2")
  )


4. ผลการวิเคราะห์และตารางสรุปทางสถิติ (Statistical Parameter Synthesis)

summary(mod_nbin)
 Family: nbinom2  ( log )
Formula:          y ~ spray * lead + (1 | block)
Data: worm_df

      AIC       BIC    logLik -2*log(L)  df.resid 
   3007.4    3038.4   -1497.7    2995.4      1294 

Random effects:

Conditional model:
 Groups Name        Variance Std.Dev.
 block  (Intercept) 0.107    0.3271  
Number of obs: 1300, groups:  block, 13

Dispersion parameter for nbinom2 family ():  2.8 

Conditional model:
                                     Estimate Std. Error z value Pr(>|z|)    
(Intercept)                           0.28347    0.10813   2.622  0.00875 ** 
sprayพ่นสาร (Spray)                   -1.01163    0.10331  -9.792  < 2e-16 ***
leadใช้เหยื่อ (Lead)                    -0.50041    0.09044  -5.533 3.14e-08 ***
sprayพ่นสาร (Spray):leadใช้เหยื่อ (Lead)  0.29143    0.15531   1.876  0.06060 .  
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

โมเดล Negative Binomial GLMM ใช้สมการบน Log scale: \[\log(\mu) = \beta_0 + \beta_1(\text{spray}) + \beta_2(\text{lead}) + \beta_3(\text{spray} \times \text{lead})\]

ตัวแปร (Predictor) Estimate (\(\beta\)) แปลงเป็นสเกลจริง \(\exp(\beta)\) \(p\)-value ความหมายทางสถิติและชีววิทยา
(Intercept) \(+0.2835\) \(\exp(0.2835) = 1.328\) \(0.00875\) ค่าเฉลี่ยคาดหมายของกลุ่มควบคุม (T1: No Spray, No Lead) สอดคล้องกับค่า emmeans ที่ได้ \(1.33\) ตัว/แปลง
spray (พ่นสาร) \(-1.0116\) \(\exp(-1.0116) = 0.364\) \(< 2 \times 10^{-16}\) เมื่อไม่ใช้เหยื่อพิษ การพ่นสารเคมีลดจำนวนหนอนลงเหลืออัตราส่วน \(\text{IRR} = 0.364\) (ลดลง \(63.6\%\)) ด้วยค่า \(z = -9.792\) ตรงกับตาราง contrast
lead (ใช้เหยื่อ) \(-0.5004\) \(\exp(-0.5004) = 0.606\) \(3.14 \times 10^{-8}\) เมื่อไม่พ่นสารเคมี การใช้เหยื่อพิษลดจำนวนหนอนลงเหลืออัตราส่วน \(\text{IRR} = 0.606\) (ลดลง \(39.4\%\)) มีนัยสำคัญยิ่งยวด (\(p < 0.0001\))
spray:lead (Interaction) \(+0.2914\) \(\exp(0.2914) = 1.338\) \(0.06060\) ปฏิกิริยาร่วมไม่มีนัยสำคัญทางสถิติที่ \(\alpha = 0.05\) (\(p = 0.061 > 0.05\)) บ่งชี้ว่าสารทั้งสองออกฤทธิ์เป็นอิสระต่อกันในเชิงคูณ

ที่มาของค่าประมาณการณ์กลุ่ม T4 (พ่นสาร + ใช้เหยื่อ)

เมื่อรวมสัมประสิทธิ์ทั้งหมดสำหรับตำรับ T4: \[\log(\mu_{\text{T4}}) = 0.2835 - 1.0116 - 0.5004 + 0.2914 = -0.9371\] แปลงกลับเป็นสเกลจำนวนตัวจริง: \[\mu_{\text{T4}} = \exp(-0.9371) = \mathbf{0.3917} \text{ ตัว/แปลง}\] (ตรงกับค่า response = 0.3917 ในตาราง emmeans อย่างแม่นยำ)

ตัวเลขสำคัญอื่น ๆ ในตารางผลลัพธ์

  • Dispersion parameter (\(\theta = 2.8\)): สูตรความแปรปรวนของ Negative Binomial (nbinom2) คือ \(\text{Var}(Y) = \mu + \frac{\mu^2}{\theta}\) การที่โมเดลประมาณค่า \(\theta = 2.8\) (ไม่ใช่ \(\infty\)) แสดงว่าข้อมูลมีความแปรปรวนเกินจริง และโมเดลได้ชดเชยค่าความแปรปรวนนี้ให้แล้ว ทำให้ Standard Error ที่รายงานออกมาไม่แคบเกินจริง
  • Random effects (block: Variance = 0.107, Std.Dev = 0.3271): บล็อกทั้ง 13 บล็อกมีความแปรปรวนระหว่างบล็อกราว \(\pm 0.33\) บน Log scale การกำหนด (1 | block) ช่วยขจัดอิทธิพลของความแปรปรวนเชิงพื้นที่ออกจากผลการเปรียบเทียบทรีตเมนต์

สรุปค่าเฉลี่ยคาดหมายรายกลุ่ม (Response Scale)

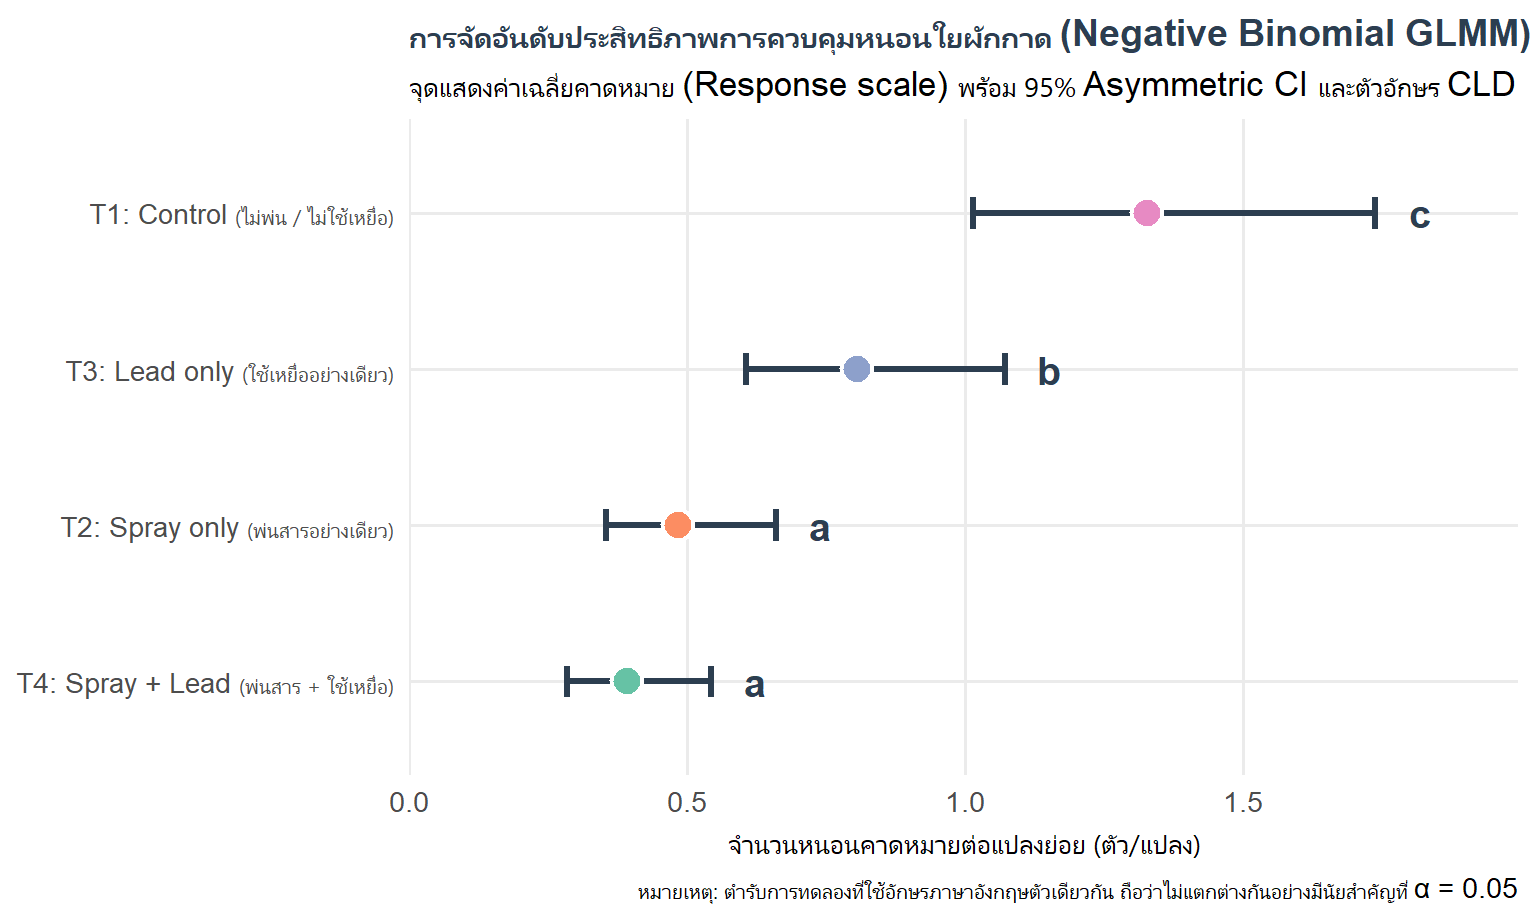
  • T1: ไม่พ่นสาร + ไม่ใช้เหยื่อ (Control): \(1.33\) ตัว/แปลง (95% CI: \(1.07 - 1.64\))
  • T2: พ่นสารอย่างเดียว (Spray only): \(0.48\) ตัว/แปลง (95% CI: \(0.38 - 0.62\))
  • T3: ใช้เหยื่ออย่างเดียว (Lead only): \(0.80\) ตัว/แปลง (95% CI: \(0.64 - 1.01\))
  • T4: พ่นสาร + ใช้เหยื่อ (Spray + Lead): \(0.39\) ตัว/แปลง (95% CI: \(0.30 - 0.51\))

การคำนวณอัตราส่วนการลดลงของแมลง (IRR) และประสิทธิผลเชิงคูณ

  1. การพ่นสารเคมีอย่างเดียว (T2 เทียบกับ T1): \[\text{IRR}_{\text{spray}} = \frac{0.4828}{1.3277} \approx 0.364\]

    • สัดส่วนประชากรหนอนที่เหลืออยู่: \(0.364\) เท่า ของกลุ่มควบคุม
    • เปอร์เซ็นต์การลดลง (Efficacy): \((1 - 0.364) \times 100\% = \mathbf{63.6\%}\)
  2. การใช้เหยื่อพิษอย่างเดียว (T3 เทียบกับ T1): \[\text{IRR}_{\text{lead}} = \frac{0.8050}{1.3277} \approx 0.606\]

    • สัดส่วนประชากรหนอนที่เหลืออยู่: \(0.606\) เท่า ของกลุ่มควบคุม
    • เปอร์เซ็นต์การลดลง (Efficacy): \((1 - 0.606) \times 100\% = \mathbf{39.4\%}\)
  3. สมการคูณเสริมกันตามทฤษฎี (Theoretical Combined IRR under Bliss Independence): เนื่องจากเทอม Interaction ไม่มีนัยสำคัญทางสถิติ (\(p = 0.0606 > 0.05\)) สารทั้งสองจึงออกฤทธิ์เป็นอิสระต่อกัน ประสิทธิภาพร่วมตามทฤษฎีเมื่อใช้คู่กันจึงเท่ากับผลคูณของแต่ละวิธี: \[\text{IRR}_{\text{combined (Expected)}} = 0.364 \times 0.606 \approx 0.221 \implies \text{คาดว่าจะลดลงได้ } 77.9\%\]

  4. เทียบกับสิ่งที่เกิดขึ้นจริงในแปลง (Observed T4 เทียบกับ T1): \[\text{IRR}_{\text{actual}} = \frac{0.3917}{1.3277} \approx 0.295 \implies \text{ลดลงได้จริงในแปลง } 70.5\%\]


5. การทดสอบเปรียบเทียบเชิงคู่และการจัดกลุ่มทรีตเมนต์ (Multiple Comparisons & CLD)

เราทำการเปรียบเทียบจับคู่ทุกทรีตเมนต์ พร้อมปรับค่า \(p\)-value แบบ Tukey บนสเกลลอการิทึม:

pairs_res <- pairs(emm_res, type = "response")
summary(pairs_res)
 contrast                                                                                      
            ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead) / พ่นสาร (Spray) ไม่ใช้เหยื่อ (No Lead)           
            ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead) / ไม่พ่นสาร (No Spray) ใช้เหยื่อ (Lead)           
            ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead) / พ่นสาร (Spray) ใช้เหยื่อ (Lead)                
            พ่นสาร (Spray) ไม่ใช้เหยื่อ (No Lead) / ไม่พ่นสาร (No Spray) ใช้เหยื่อ (Lead)                
            พ่นสาร (Spray) ไม่ใช้เหยื่อ (No Lead) / พ่นสาร (Spray) ใช้เหยื่อ (Lead)                     
            ไม่พ่นสาร (No Spray) ใช้เหยื่อ (Lead) / พ่นสาร (Spray) ใช้เหยื่อ (Lead)                     
 ratio    SE  df null z.ratio p.value
  2.75 0.284 Inf    1   9.792 <0.0001
  1.65 0.149 Inf    1   5.533 <0.0001
  3.39 0.372 Inf    1  11.123 <0.0001
  0.60 0.066 Inf    1  -4.648 <0.0001
  1.23 0.156 Inf    1   1.655  0.3480
  2.05 0.238 Inf    1   6.209 <0.0001

P value adjustment: tukey method for comparing a family of 4 estimates 
Tests are performed on the log scale 

การแปลผลเปรียบเทียบเชิงคู่ (Pairwise Contrasts with Tukey Adjustment)

กลุ่มที่ 1: เปรียบเทียบกับกลุ่มควบคุม (T1: ไม่พ่น/ไม่ใช้เหยื่อ) * T1 / T2 = 2.75 (\(p < 0.0001\)): แปลงควบคุม (T1) มีหนอนมากกว่าแปลงพ่นสาร (T2) ถึง \(2.75\) เท่า หรือคิดกลับกันคือการพ่นสารเคมีอย่างเดียวลดประชากรหนอนลงเหลือเพียง \(1 / 2.75 = 0.364\) เท่า (ลดลง \(63.6\%\)) * T1 / T3 = 1.65 (\(p < 0.0001\)): แปลงควบคุม (T1) มีหนอนมากกว่าแปลงใช้เหยื่อ (T3) \(1.65\) เท่า หรือคิดเป็นเหยื่อพิษลดประชากรหนอนลงเหลือ \(1 / 1.65 = 0.606\) เท่า (ลดลง \(39.4\%\)) * T1 / T4 = 3.39 (\(p < 0.0001\)): แปลงควบคุม (T1) มีหนอนมากกว่าแปลงที่ใช้ทั้งสองวิธีร่วมกัน (T4) ถึง \(3.39\) เท่า (T4 ลดจำนวนหนอนลงเหลือเพียง \(0.295\) เท่า หรือลดลง \(70.5\%\))

กลุ่มที่ 2: เปรียบเทียบประสิทธิภาพระหว่างวิธีจัดการ (T2, T3, T4) * T2 / T3 = 0.60 (\(p < 0.0001\)): แปลงพ่นสาร (T2) พบหนอนคิดเป็น \(60\%\) ของแปลงใช้เหยื่อ (T3) หรือพบน้อยกว่าประมาณ \(40\%\) แสดงว่าการพ่นสารเคมีสัมผัสตายควบคุมหนอนได้ดีกว่าการใช้เหยื่อพิษอย่างมีนัยสำคัญ * T2 / T4 = 1.23 (\(p = 0.3480\)): ไม่มีนัยสำคัญทางสถิติ (\(p > 0.05\)) แม้ T4 จะพบหนอนน้อยกว่า T2 เล็กน้อย แต่ความต่างนี้ไม่ถึงระดับนัยสำคัญ ในเชิงการลงทุน การพ่นสารเคมีสัมผัสตายเพียงอย่างเดียว (T2) ก็เพียงพอแล้วโดยไม่จำเป็นต้องซื้อเหยื่อพิษเพิ่ม * T3 / T4 = 2.05 (\(p < 0.0001\)): แปลงใช้เหยื่ออย่างเดียว (T3) มีหนอนมากกว่าแปลงที่ทำทั้งสองอย่าง (T4) ถึง \(2.05\) เท่า แสดงว่าการใช้เหยื่อพิษอย่างเดียวควบคุมหนอนได้ด้อยกว่าการใช้ร่วมกับการพ่นสารอย่างมาก


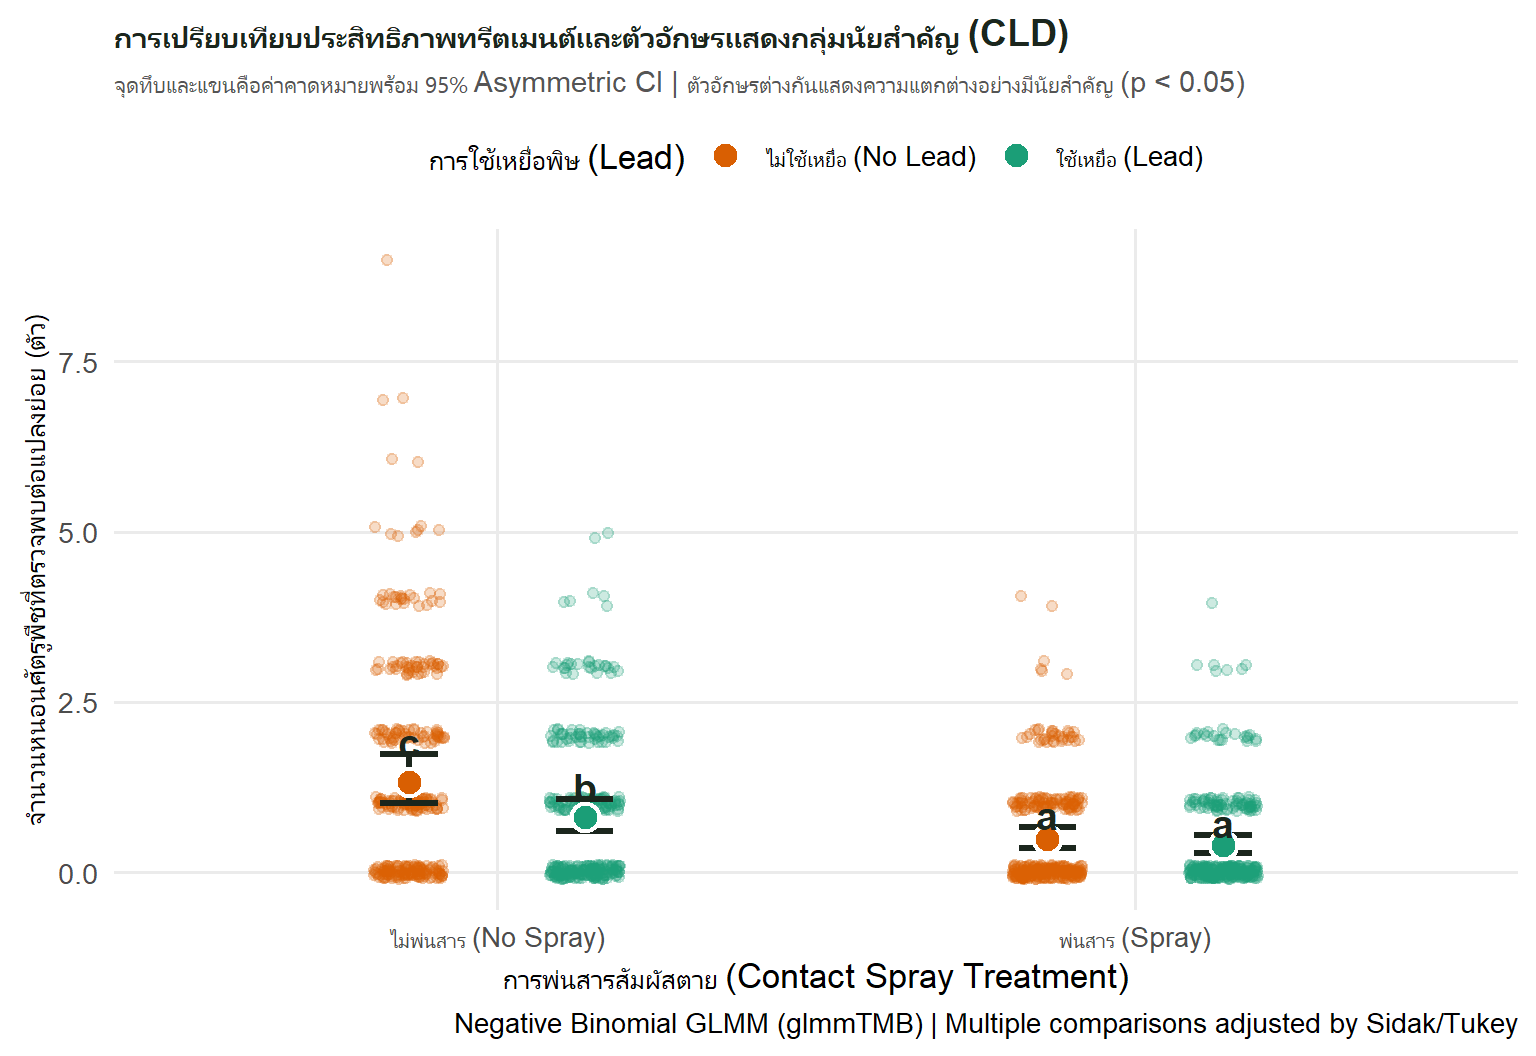
การจัดกลุ่มตัวอักษรด้วย Compact Letter Display (CLD)

library(multcomp)
cld_res <- cld(emm_res, Letters = letters, adjust = "sidak")
cld_df <- as.data.frame(cld_res) |>
  mutate(.group = stringr::str_trim(.group))
cld_df
               spray               lead  response         SE  df asymp.LCL
4      พ่นสาร (Spray)      ใช้เหยื่อ (Lead) 0.3917425 0.05109299 Inf 0.2830794
2      พ่นสาร (Spray) ไม่ใช้เหยื่อ (No Lead) 0.4827957 0.06034845 Inf 0.3536241
3 ไม่พ่นสาร (No Spray)      ใช้เหยื่อ (Lead) 0.8049737 0.09228395 Inf 0.6050104
1 ไม่พ่นสาร (No Spray) ไม่ใช้เหยื่อ (No Lead) 1.3277277 0.14356488 Inf 1.0142310
  asymp.UCL .group
4 0.5421172      a
2 0.6591511      a
3 1.0710273      b
1 1.7381256      c

การจัดกลุ่มแสดงให้เห็นข้อค้นพบเชิงปฏิบัติที่ชัดเจน: * T4 (Spray + Lead): ได้กลุ่มตัวอักษร a (ค่าเฉลี่ย \(0.39\) ตัว) * T2 (Spray only): ได้กลุ่มตัวอักษร a (ค่าเฉลี่ย \(0.48\) ตัว) * T3 (Lead only): ได้กลุ่มตัวอักษร b (ค่าเฉลี่ย \(0.80\) ตัว) * T1 (Control): ได้กลุ่มตัวอักษร c (ค่าเฉลี่ย \(1.33\) ตัว)

เนื่องจาก T2 และ T4 จัดอยู่ในกลุ่มอักษร a เดียวกัน แสดงว่า การพ่นสารเคมีสัมผัสตายเป็นกลไกหลักในการควบคุมหนอน และการเพิ่มเหยื่อพิษเข้าไปร่วมด้วยไม่ได้เพิ่มประสิทธิภาพการควบคุมอย่างมีนัยสำคัญทางสถิติ

กราฟเปรียบเทียบแบบที่ 1: Factorial Point-Range with Jitter & CLD

ggplot() +
  # 1. เลเยอร์ข้อมูลดิบจริง (Raw Counts) แสดงการกระจายตัวและค่าศูนย์
  geom_jitter(
    data = worm_df,
    aes(x = spray, y = y, color = lead),
    position = position_jitterdodge(
      jitter.width = 0.22,
      jitter.height = 0.1,
      dodge.width = 0.55
    ),
    alpha = 0.22,
    size = 1.8
  ) +
  # 2. เลเยอร์ 95% Asymmetric CI จาก Negative Binomial GLMM
  geom_errorbar(
    data = cld_df,
    aes(x = spray, ymin = asymp.LCL, ymax = asymp.UCL, group = lead),
    position = position_dodge(width = 0.55),
    width = 0.18,
    linewidth = 1.1,
    color = "#1B261D"
  ) +
  # 3. เลเยอร์ค่าเฉลี่ยคาดหมาย (Predicted Marginal Means) บน Response Scale
  geom_point(
    data = cld_df,
    aes(x = spray, y = response, fill = lead),
    position = position_dodge(width = 0.55),
    size = 4.2,
    shape = 21,
    color = "#FFFFFF",
    stroke = 1.3
  ) +
  # 4. เลเยอร์ตัวอักษร CLD กำกับเหนือแขน CI แต่ละกลุ่ม
  geom_text(
    data = cld_df,
    aes(x = spray, y = asymp.UCL + 0.18, label = .group, group = lead),
    position = position_dodge(width = 0.55),
    fontface = "bold",
    size = 5.2,
    color = "#1B261D"
  ) +
  scale_color_manual(
    values = c("ไม่ใช้เหยื่อ (No Lead)" = "#D95F02", "ใช้เหยื่อ (Lead)" = "#1B9E77"),
    name = "การใช้เหยื่อพิษ (Lead)"
  ) +
  scale_fill_manual(
    values = c("ไม่ใช้เหยื่อ (No Lead)" = "#D95F02", "ใช้เหยื่อ (Lead)" = "#1B9E77"),
    name = "การใช้เหยื่อพิษ (Lead)"
  ) +
  labs(
    title = "การเปรียบเทียบประสิทธิภาพทรีตเมนต์และตัวอักษรแสดงกลุ่มนัยสำคัญ (CLD)",
    subtitle = "จุดทึบและแขนคือค่าคาดหมายพร้อม 95% Asymmetric CI | ตัวอักษรต่างกันแสดงความแตกต่างอย่างมีนัยสำคัญ (p < 0.05)",
    x = "การพ่นสารสัมผัสตาย (Contact Spray Treatment)",
    y = "จำนวนหนอนศัตรูพืชที่ตรวจพบต่อแปลงย่อย (ตัว)",
    caption = "Negative Binomial GLMM (glmmTMB) | Multiple comparisons adjusted by Sidak/Tukey"
  ) +
  theme_minimal(base_size = 13) +
  theme(
    legend.position = "top",
    plot.title = element_text(face = "bold", size = 14, color = "#1B261D"),
    plot.subtitle = element_text(size = 11, color = "#555555"),
    panel.grid.minor = element_blank(),
    strip.background = element_rect(fill = "#FAF9F4", color = "#DDDCD2")
  )

กราฟเปรียบเทียบแบบที่ 2: Horizontal Ranked Dot Plot (Forest Plot)

cld_ranked <- cld_df |>
  mutate(
    treatment = case_when(
      spray == "ไม่พ่นสาร (No Spray)" &
        lead == "ไม่ใช้เหยื่อ (No Lead)" ~ "T1: Control (ไม่พ่น / ไม่ใช้เหยื่อ)",
      spray == "ไม่พ่นสาร (No Spray)" &
        lead == "ใช้เหยื่อ (Lead)" ~ "T3: Lead only (ใช้เหยื่ออย่างเดียว)",
      spray == "พ่นสาร (Spray)" &
        lead == "ไม่ใช้เหยื่อ (No Lead)" ~ "T2: Spray only (พ่นสารอย่างเดียว)",
      spray == "พ่นสาร (Spray)" &
        lead == "ใช้เหยื่อ (Lead)" ~ "T4: Spray + Lead (พ่นสาร + ใช้เหยื่อ)"
    ),
    # เรียงลำดับทรีตเมนต์ตามค่าเฉลี่ยคาดหมาย
    treatment = fct_reorder(treatment, response)
  )

ggplot(cld_ranked, aes(y = treatment, x = response)) +
  # 1. แขน 95% Confidence Interval แนวนอน
  geom_errorbar(
    aes(xmin = asymp.LCL, xmax = asymp.UCL),
    width = 0.2,
    linewidth = 1.1,
    color = "#2C3E50"
  ) +
  # 2. จุดค่าเฉลี่ยคาดหมาย
  geom_point(
    aes(fill = treatment),
    shape = 21,
    size = 4.8,
    stroke = 1.2,
    color = "#FFFFFF"
  ) +
  # 3. ตัวอักษร CLD วางทางขวาของปลายแขน CI
  geom_text(
    aes(x = asymp.UCL + 0.08, label = .group),
    fontface = "bold",
    size = 5.2,
    color = "#2C3E50"
  ) +
  scale_x_continuous(
    limits = c(0, 1.9),
    expand = expansion(mult = c(0, 0.05))
  ) +
  scale_fill_brewer(palette = "Set2", guide = "none") +
  labs(
    title = "การจัดอันดับประสิทธิภาพการควบคุมหนอนใยผักกาด (Negative Binomial GLMM)",
    subtitle = "จุดแสดงค่าเฉลี่ยคาดหมาย (Response scale) พร้อม 95% Asymmetric CI และตัวอักษร CLD",
    x = "จำนวนหนอนคาดหมายต่อแปลงย่อย (ตัว/แปลง)",
    y = NULL,
    caption = "หมายเหตุ: ตำรับการทดลองที่ใช้อักษรภาษาอังกฤษตัวเดียวกัน ถือว่าไม่แตกต่างกันอย่างมีนัยสำคัญที่ α = 0.05"
  ) +
  theme_minimal(base_size = 13) +
  theme(
    plot.title = element_text(face = "bold", size = 14, color = "#2C3E50"),
    panel.grid.minor = element_blank()
  )


6. บทเรียนทางสถิติ: ทำไม Interaction ใน ANOVA จึงขัดแย้งกับ GLMM? (Scale-Dependent Interaction)

ประเด็นที่น่าสนใจที่สุดในชุดข้อมูลนี้คือ: * เมื่อวิเคราะห์ด้วย ANOVA บนข้อมูลที่แปลงด้วยรากที่สอง \(\sqrt{y + 0.5}\) ผลของปฏิกิริยาร่วม spray:lead กลับมีนัยสำคัญยิ่งยวด (\(p = 0.000858\)) * แต่เมื่อวิเคราะห์ด้วย Negative Binomial GLMM บน Log scale ปฏิกิริยาร่วม spray:lead กลับไม่มีนัยสำคัญทางสถิติ (\(p = 0.06060\))

ทำไมผลการวิเคราะห์ถึงขัดแย้งกันอย่างสิ้นเชิง? คำตอบคือ Interaction ใน ANOVA เกิดจากภาพลวงตาของการแปลงสเกล (Scale Artifact): 1. การถอดรากที่สองบีบอัดสเกลตัวเลขไม่เป็นเชิงเส้น ทำให้ความสัมพันธ์แบบทวีคูณ (Multiplicative) ของชีววิทยาในธรรมชาติ ถูกบิดจนสูญเสียโครงสร้างเชิงบวก/คูณไป 2. เมื่อนำข้อมูลที่ถูกบิดไปใส่ในโมเดลเส้นตรง (Linear Model) ที่สมมติความสัมพันธ์แบบบวก (Additive) โมเดลจึงต้องสร้าง Interaction Term ขึ้นมาชดเชยส่วนโค้งที่ผิดรูป 3. ในทางตรงกันข้าม GLMM ใช้ Log link function ซึ่งตรงกับธรรมชาติแบบ Multiplicative กลไกอิสระจึงถูกคงไว้อย่างถูกต้องโดยไม่เกิด Interaction เทียม


7. แนวทางปฏิบัติ 4 ขั้นตอนสำหรับนักวิจัยชีววิทยาและเกษตรศาสตร์ (A 4-Step Practical Workflow)

หากคุณกำลังทำวิทยานิพนธ์ หรือเตรียมเขียนบทความวิจัยที่มีตัวแปรตามเป็น ข้อมูลจำนวนนับ (จำนวนแมลง, จำนวนจุดแผลโรคพืช, จำนวนวัชพืช, จำนวนเมล็ดติด) นี่คือกระบวนการวิเคราะห์ 4 ขั้นตอนที่ได้รับการยอมรับในวารสารระดับนานาชาติ:

[ขั้นตอนที่ 1: ตรวจสอบ Mean-Variance & Zero Proportion]
  │  └── คำนวณ var(y) / mean(y) ในแต่ละทรีตเมนต์ หากอัตราส่วน > 1.2 สันนิษฐานว่ามี Overdispersion
  ▼
[ขั้นตอนที่ 2: ฟิตโมเดล GLMM ด้วย glmmTMB]
  │  ├── เริ่มต้นฟิตทั้ง Poisson และ Negative Binomial (nbinom2)
  │  └── ใส่ Random Effects ตามแผนการทดลอง เช่น (1 | block) หรือ (1 | rep)
  ▼
[ขั้นตอนที่ 3: วินิจฉัย Residuals ด้วยแพ็กเกจ DHARMa]
  │  ├── simulateResiduals(model) -> testDispersion() และ testZeroInflation()
  │  └── หาก Poisson ไม่ผ่าน ให้เลือกใช้ Negative Binomial เป็นโมเดลหลัก
  ▼
[ขั้นตอนที่ 4: สกัดผลและรายงานเป็น Response Scale & IRR]
     ├── ใช้ emmeans(model, ~ trt, type = "response") เพื่อรายงานค่าเฉลี่ยและ 95% CI จริง
     └── คำนวณ contrast(..., type = "response") เพื่อรายงาน % Efficacy = (1 - IRR) x 100%

8. สรุปประเด็นสำคัญสำหรับนำไปใช้จริง (Key Takeaways)

จากข้อมูล beall.webworms ใน tidyTuesday EP.2 มอบหลักคิดสำคัญ 4 ประการที่ช่วยยกระดับงานวิเคราะห์สถิติเกษตรและชีววิทยา:

Tipกฎ 4 ข้อสำหรับข้อมูลนับจำนวนทางวิทยาศาสตร์เกษตร
  1. ให้โมเดลปรับตัวเข้าหาข้อมูล ไม่ใช่บิดข้อมูลให้เข้าหาโมเดล (Model the data as they are): ข้อมูลนับจำนวนมีความไม่ต่อเนื่องและมีขอบเขตล่างที่ศูนย์ การเลือกใช้ Generalized Linear Models ที่ตรงกับการแจกแจงทางธรรมชาติ ย่อมให้ผลลัพธ์ที่ซื่อสัตย์กว่าการพยายามแปลงข้อมูลให้กลายเป็นเส้นโค้งปกติ
  2. ตระหนักถึงหลุมพราง Jensen’s Inequality และ Transformation Bias: การถอดรากที่สอง \(\sqrt{y+0.5}\) หรือเทคล็อก \(\log(y+1)\) แล้วคำนวณย้อนกลับด้วยการยกกำลังสองหรือ \(\exp\) จะได้ค่าที่ต่ำกว่าความเป็นจริงในธรรมชาติเสมอ (ในการทดลองนี้ต่ำไปถึง 16–20%) ซึ่งเป็นอันตรายต่อการประเมินระดับเศรษฐกิจของศัตรูพืช
  3. ใช้ประโยชน์จาก Incidence Rate Ratio (IRR) บนสเกลลอการิทึม: สัมประสิทธิ์บนสเกล Log link สามารถแปลงเป็นเปอร์เซ็นต์ประสิทธิผลของการควบคุม \((1 - \text{IRR}) \times 100\%\) ได้โดยตรง ซึ่งสื่อสารได้อย่างชัดเจนตรงไปตรงมา
  4. ตรวจสอบ Overdispersion ทุกครั้งด้วย DHARMa: อย่าด่วนสรุปใช้โมเดล Poisson เพียงเพราะมันเป็นข้อมูลนับจำนวน เพราะในธรรมชาติสิ่งมีชีวิตมักกระจายตัวเป็นกลุ่มก้อน การเปรียบเทียบ AIC และทดสอบ Dispersion เสมอจะช่วยคุ้มครองคุณจากผลบวกลวง (False Positive / Type I Error)

9. เอกสารอ้างอิง (References)

  • Beall, G. (1940). The fit and significance of contagious distributions when applied to observations on larval insects. Ecology, 21(4), 460–474. https://doi.org/10.2307/1930285
  • O’Hara, R. B., & Kotze, D. J. (2010). Do not log-transform count data. Methods in Ecology and Evolution, 1(2), 118–122. https://doi.org/10.1111/j.2041-210X.2010.00021.x
  • Stroup, W. W. (2015). Rethinking the analysis of non-normal data in plant and soil science. Agronomy Journal, 107(2), 811–827. https://doi.org/10.2134/agronj2013.0342
  • Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400.
  • Hartig, F. (2022). DHARMa: Residual Diagnostics for Hierarchical (Multi-Level / Mixed) Regression Models. R package version 0.4.6. https://CRAN.R-project.org/package=DHARMa
  • Lenth, R. V. (2024). emmeans: Estimated Marginal Means, aka Least-Squares Means. R package version 1.10.0. https://CRAN.R-project.org/package=emmeans
  • Wright, K. (2023). agridat: Agricultural Datasets. R package version 1.22. https://CRAN.R-project.org/package=agridat